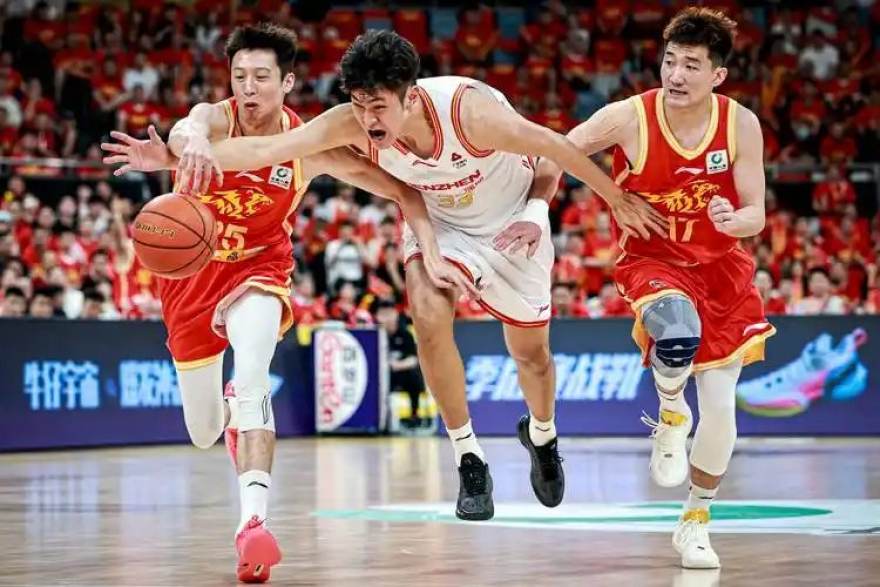
赛前预测的价值不在于给出一个确定答案,而在于把比赛的不确定性拆解成可比较、可讨论的维度。看个球在每场比赛页面呈现的胜平负概率,背后是一条从原始数据到模型输出的完整链路,理解这条链路,比记住某个具体数字更有用。
一、预测的起点:哪些数据真正进入模型
结论前置:一场比赛的预测质量,首先取决于输入数据的覆盖度与清洗质量,而不是模型本身有多复杂。看个球的数据团队在赛前会围绕三类信息做结构化整理:历史交锋、近期状态、阵容与赛程环境。
历史交锋并非简单统计胜负场次,而是按主客场、赛事类型、时间跨度做加权。三年前的一场大胜,参考价值远低于上赛季同主客条件下的对局。近期状态则通常取最近若干场,并区分对手强度,避免“连胜弱队”被误读为状态火热。
阵容与赛程环境是最容易被球迷忽略的部分。伤停名单、累计黄牌停赛、连续客场带来的旅途消耗、以及赛事之间的间隔天数,都会进入特征池。看个球在整理这些信息时,以联赛官网与赛事组织方公告为一手来源,无法核验的数字不会被写入模型。
- 历史交锋:按主客场与时间衰减加权,而非简单计数
- 近期状态:区分对手强度,剔除无效连胜
- 阵容环境:伤停、停赛、旅途与休息天数
二、模型输入项:四个维度如何变成一组概率
结论前置:胜平负概率是多个特征共同作用的结果,单一维度不足以决定输出。看个球的预测模型围绕进攻效率、防守稳定性、比赛节奏、主场因素四个输入项构建。
进攻效率看的是创造机会的能力与转化效率,两者要分开看:一支球队可能射门很多但转化偏低,另一支射门不多但每次机会质量高。防守稳定性同理,被射门次数与失球数之间的偏差,往往指向门将表现或运气成分,这类偏差在长期样本中会回归。
比赛节奏决定了比赛的“回合数”。节奏快的球队之间对碰,进球期望通常更高;节奏慢的球队相遇,平局概率会被抬高。主场因素则要结合联赛特点,不同联赛的主场优势幅度差异明显,不能一概而论。
这四个维度进入模型后,输出的是一组概率分布,而不是一个确定比分。看个球在页面上展示的百分比,是经过校准后的结果,含义是“在类似条件下重复多次,各类结果出现的比例”。
三、概率的边界:什么时候该信,什么时候该疑
结论前置:概率描述的是长期倾向,不是单场保证。任何一场比赛都可能出现小概率结果,这正是体育比赛的基本属性。
当模型输出与市场共识、球迷直觉出现明显分歧时,通常有三种可能:模型捕捉到了被忽略的信息,比如隐蔽的伤停或赛程疲劳;模型输入存在滞后,比如阵容公告晚于数据更新;或者这本来就是一场高方差比赛,比如杯赛淘汰赛阶段。
看个球在呈现预测时坚持结论前置、依据在后,目的是赛事对比迷看到数字背后的推理过程,而不是被动接受一个结论。遇到分歧时,建议先回看输入项:交锋样本是否足够、近期状态是否被对手强度污染、阵容信息是否已更新。这套自查方法,比反复刷新概率数字更有意义。
- 先看样本量:交锋与近期状态的样本是否足够支撑结论
- 再看时效性:阵容与赛程信息是否已同步最新公告
- 最后看方差:杯赛与德比类比赛本身波动更大
理解这套逻辑之后,再看个个球页面上的每一个百分比,都会变成一个有依据、可讨论的判断,而不是一个孤立的数字。看个球希望提供的正是这种“看得明明白白”的观赛体验。
老周看球
北看台阿凯
数据小白李
南门老球迷
周末球场见
看球的猫